

記事執筆者:認定SEOコンサルタント 三田健司
「robots.txtという言葉は聞くけれど、自社サイトで何をすればよいのか分からない」「AIに情報を使われたくないので、robots.txtで止めたほうがいいのか」。最近、ホームページを運営している中小企業の経営者やWeb担当者の方から、こうしたご相談をいただくことが増えています。
robots.txtは、サイトの入口に置く短いテキストファイルです。数行の書き方の違いで、検索エンジンがサイトを正しく巡回できるかどうかが変わるため、SEOの土台として欠かせない存在です。
一方で、この1年ほどでAI検索が広がり、Googleもクローラーや検索の設定に関する説明を何度も更新してきました。以前の「robots.txtで止めれば検索にもAIにも出ない」という理解のままでは、思わぬ形で集客を失うおそれがあります。
この記事では、robots.txtの基本から、書き方と目的別の記述例、Googleの読み取りの仕様、WordPressでの設置と確認の手順、そしてAI時代に気をつけたい点までを、最新の公式情報をもとに整理します。
筆者は全日本SEO協会認定SEOコンサルタントとして、Web制作とSEOに10年以上携わり、延べ1,000件以上のご相談に対応してきました。robots.txtの1行が原因でサイトが検索から消えかけた例も見てきたので、その注意点もあわせてお伝えします。
robots.txtとは|クローラーに巡回の範囲を伝えるファイル
まずは、robots.txtがどのような役割のファイルなのかを確認します。ここを正しく理解しておくと、後で出てくる書き方や注意点がぐっと分かりやすくなります。
robots.txtの役割
robots.txtとは、検索エンジンなどのクローラー(Webページを自動で巡回して情報を集めるプログラム)に対して、サイトのどこを巡回してよいかを伝えるテキストファイルです。Googleのクローラーであれば、Googlebotがこのファイルを最初に確認してから巡回を始めます。
Googleはrobots.txtの主な目的を、クローラーからのアクセスでサーバーに負荷がかかりすぎないようにすることだと説明しています。robots.txtは「巡回してよい場所」を伝えるもので、「検索結果に出さない」ための仕組みではありません。
たとえるなら、建物の入口に置いた「関係者以外立ち入り禁止」の案内板のようなものです。案内板を見たクローラーは、その部屋には入らずに巡回を続けます。
置き場所と効く範囲
robots.txtは、サイトのいちばん上の階層に「robots.txt」という名前で置きます。たとえば当社のサイトなら「https://access-link.co.jp/robots.txt」です。
Googleの仕様では、robots.txtが効くのは、置いたファイルと同じプロトコル・ホスト名・ポート番号のURLだけです。つまり、wwwの有無やサブドメインが違えば、それぞれに別のrobots.txtが必要になります。
サブフォルダの中に置いたrobots.txtは読まれません。ブログを「blog.」で始まるサブドメインで運営している場合は、そのサブドメインの直下にも用意しておきましょう。
noindexとの違い
robots.txtとよく混同されるのが、noindexです。noindexは、ページをインデックス(検索エンジンのデータベースへの登録)せず、検索結果に表示しないよう伝える指示です。
robots.txtで巡回を止めたページは、Googleが中身を読めなくなるだけで、ほかのサイトからリンクされていればURLだけが検索結果に出ることがあります。ページを検索結果から外したいなら、robots.txtではなくnoindexを使うのが正しい方法です。
両者の使い分けは、別の記事で詳しく解説しています。
仕様は国際的な標準として決められている
robots.txtのルールは、1994年ごろから検索エンジン各社の慣習として使われてきました。その後、2022年にRFC 9309としてインターネットの標準仕様にまとめられています。
Googleのクローラーは、この標準仕様に沿ってrobots.txtを読み取ります。ただし、どの項目に対応しているかは検索エンジンやサービスごとに違うため、Googleで有効な書き方がほかのサービスでも同じように働くとは限りません。
本記事では、特に断りがない限り、Googleの仕様にもとづいて説明します。
robots.txtを守らないアクセスもある
robots.txtはあくまで「お願い」であり、アクセスを物理的に止める仕組みではありません。Googleや主要な検索エンジンのクローラーは従いますが、悪意のあるプログラムは無視することがあります。
また、Googleは、利用者の操作をきっかけにページを取得するプログラム(ユーザーによって開始される取得)は、一般にrobots.txtのルールを無視すると説明しています。たとえば、Gemini Notebookで利用者が資料として指定したURLを読み込む場合などです。
見られて困る情報は、robots.txtではなくパスワードやアクセス制限で守る、という原則を必ず押さえておいてください。
この1年で変わったこと|AI時代のrobots.txt
robots.txtの書き方そのものは、何年も大きくは変わっていません。しかし、この1年ほどで、AI検索との関係やGoogleの説明の仕方は大きく変わりました。
ここでは、中小企業のサイト運営に関係する3つの変化と、あわせて確認しておきたい点を紹介します。
Googleの公式ページに「検索の生成AI設定」が加わった
Googleは2026年10月21日、検索に出す内容を制限する方法をまとめた公式ページ「Control what you share with Google Search」を更新し、検索の生成AI設定やrobotsメタタグなどを加えた7つの方法を一覧にしました。
この表でも、robots.txtでクロールを禁止する方法の対象は以前から「画像と動画」とされています。Webページを検索から外すにはnoindexを使う、という区別が改めて確認できます。
7つの方法の違いと選び方は、別の記事でまとめています。
AI検索だけ外すなら「検索の生成AI設定」
2026年8月31日、Search Consoleの「検索の生成AI設定」が世界中のすべてのウェブサイトに提供されました。この設定で、AIによる概要・AIモード・Discoverの生成AI機能に、自社サイトを含めるかどうかを選べます。
Search Consoleヘルプには、この設定は検索のほかの部分に影響するランキングのシグナルとしては使われないと書かれています。以前のように「AIに使われたくないからGooglebotをrobots.txtで止める」と、通常の検索からの集客まで失うことになるため、目的に合った方法を選ぶことが大切です。
Googleも、AI機能とウェブサイトに関するドキュメントで、Googlebotに対するrobots.txtの指示は、検索のためのクロールを管理する手段だと説明しています。
Google-Extendedの役割を確認しておく
GoogleのAIサービスでの学習や利用を制限したい場合に使うのが、robots.txtで指定する「Google-Extended」です。Googleのクローラーの一覧ページ(2026年10月15日時点)では、Google-Extendedの役割が次のように説明されています。
それは、GeminiアプリやVertex AIのGemini APIを支えるモデルの学習と、GeminiアプリなどでGoogle検索の情報を回答の根拠として使うこと(グラウンディング)に、自社サイトの内容を使わせるかどうかを管理する仕組みです。Google-Extendedを設定しても、Google検索への掲載や順位には影響しないとも明記されています。
なお、検索の生成AI設定はAIの学習には影響しません。検索のAI機能に使われるモデルの学習を制限したい場合も、Google-Extendedを使います。
つまり、「検索結果のAI機能に出たくない」なら検索の生成AI設定、「Googleのほかの生成AIサービスでの利用を制限したい」ならGoogle-Extended、と目的で使い分けます。
Google-Agentなど新しい取得の仕組みが登場した
Googleは2026年3月20日、クローラーのドキュメントに「Google-Agent」を追加しました。Googleの基盤で動くAIエージェントが、利用者の依頼を受けてWebを移動したり操作を行ったりするときに使われるものです。
Google-Agentは、利用者の操作をきっかけにページを取得するプログラムの一覧に含まれています。先ほど触れたとおり、こうしたプログラムは一般にrobots.txtのルールを無視するとGoogleは説明しています。
また2026年7月には、NotebookLMの名称変更に合わせて、取得に使う名前が「Google-GeminiNotebook」に変わりました。サーバーのアクセスログで見慣れない名前を見つけたら、Googleのドキュメントで確認すると安心です。
robots.txtの書き方|基本の4項目
ここからは、robots.txtの具体的な書き方を見ていきます。Googleが対応している項目は4つだけなので、ひとつずつ押さえれば難しくありません。
User-agent|どのクローラーへの指示かを決める
User-agentは、続くルールがどのクローラーに向けたものかを指定する項目です。「*」と書けばすべてのクローラーが対象になり、「Googlebot」と書けばGoogle検索のクローラーが対象になります(画像用のGooglebot-Imageなど、専用のまとまりがないGoogleの一部のクローラーにも適用されます)。
1つのrobots.txtに、クローラーごとの指示のまとまり(グループ)を複数書くこともできます。クローラーは、自分の名前にいちばん具体的に当てはまるグループだけに従います。
項目名の大文字と小文字は区別されませんが、読みやすさのため「User-agent」と書くのが一般的です。
DisallowとAllow|巡回してよい場所といけない場所
Disallowは巡回してほしくない場所を、Allowは巡回してよい場所を指定します。たとえば「Disallow: /wp-admin/」と書けば、管理画面のフォルダ以下が巡回の対象から外れます。
Allowは、Disallowで止めたフォルダの中に、例外的に巡回してほしいファイルがある場合に使います。WordPressで管理画面のフォルダを止めつつ、「admin-ajax.php」だけを許可するのが代表的な例です。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap|サイトマップの場所を伝える
Sitemapは、XMLサイトマップの場所をクローラーに伝える項目です。ほかの項目と違い、どのクローラーへの指示のまとまりにも属さないため、ファイルのどこに書いても構いません。
URLは「https://」などから始まる完全な形で書きます。サイトマップが複数ある場合は、Sitemapの行を複数並べることもできます。
ワイルドカードと優先順位
Googleは、パスの指定に「*」(0文字以上の任意の文字)と「$」(URLの末尾)の2つの記号を使えます。たとえば「Disallow: /*.pdf$」と書けば、末尾が「.pdf」のURLをまとめて指定できます。
AllowとDisallowの両方に当てはまるURLでは、パスがより長く具体的なルールが優先されます。同じ長さで迷う場合は、制限のゆるいAllowのほうが使われるというのがGoogleの仕様です。
「crawl-delay」や「noindex」をrobots.txtに書いても、Googleは対応していません。古い解説記事を参考にした記述が残っていないか、一度見直してみてください。
目的別の記述例
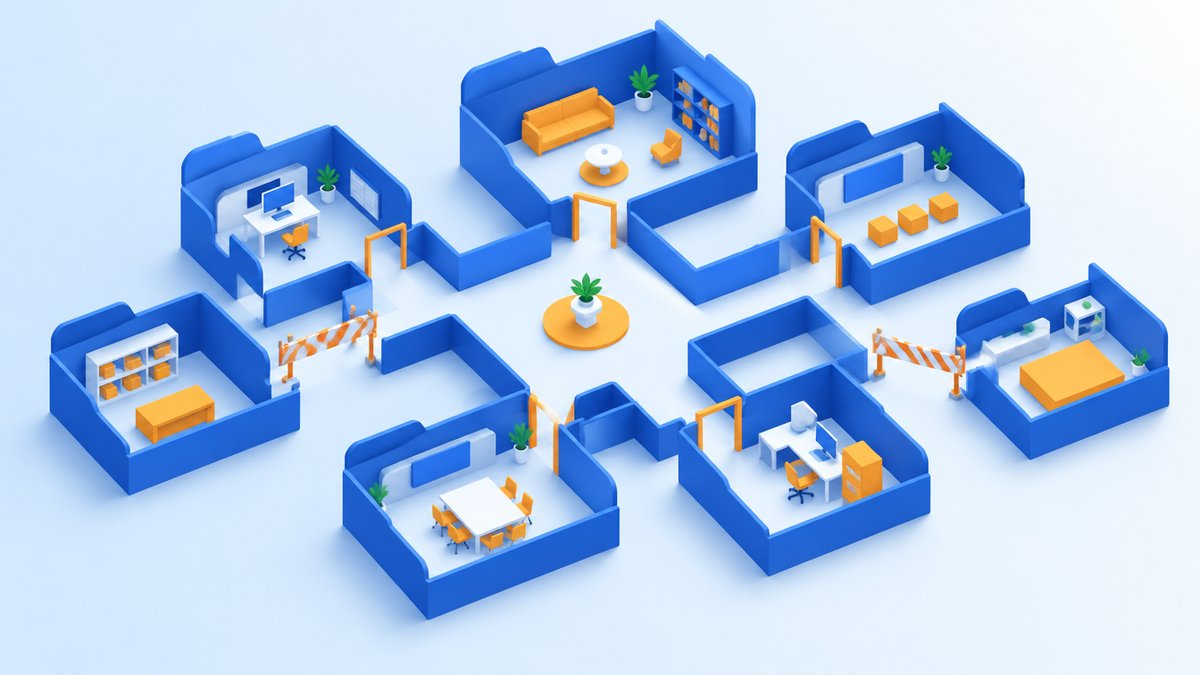
次に、中小企業のサイトでよく使う記述例を目的別に紹介します。そのまま使う場合も、自社のフォルダ名に合わせて書き換えてください。
WordPressの標準的な記述
WordPressでは、robots.txtのファイルを置いていなくても、WordPressが自動で内容を作って返します。標準の内容は、管理画面のフォルダを止めて「admin-ajax.php」だけを許可するものです。
WordPress 5.5以降では、標準のXMLサイトマップ(wp-sitemap.xml)の場所も自動で追記されます。SEOプラグインを使っている場合は、プラグインのサイトマップのURLになることがあります。
当社のサイトも、管理画面のフォルダを止める指定と、サイトマップの場所だけを書いたシンプルな内容です。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://access-link.co.jp/sitemap.xml中小企業のサイトの多くは、この標準的な内容で十分です。迷ったら、まずは何も足さないことをおすすめします。
サイト内検索の結果ページを止める
サイト内検索の結果ページは、検索語の数だけURLが生まれるため、クローラーが無駄に巡回してしまうことがあります。WordPressの場合、検索結果のURLには「?s=」が付くため、次のように書けば巡回を止められます。
User-agent: *
Disallow: /?s=
Disallow: /search/
ただし、すでに検索結果ページがインデックスされている場合は、先にnoindexで外してからrobots.txtで止める、という順番が必要です。Googleの最新の見解は別の記事で解説しています。
特定の画像や動画のフォルダを止める
画像や動画を検索に出したくない場合、robots.txtは有効な手段です。Googleは、Googlebotのクロールが許可された画像と動画だけをインデックスすると説明しています。
User-agent: Googlebot-Image
Disallow: /wp-content/uploads/private/
この例では、Google画像検索用のクローラーに対して、アップロードフォルダの中の「private」という場所だけを止めています。サイト全体の画像を止めると、画像検索からの集客を失うので注意してください。
Googleのほかの生成AIサービスでの利用を制限する
Geminiモデルの学習や、Geminiアプリなどでのグラウンディングへの利用を制限したい場合は、Google-Extendedを指定します。Google-Extendedは実際に巡回するクローラーの名前ではなく、robots.txtで意思を伝えるための専用の名前です。
User-agent: Google-Extended
Disallow: /
他社のAIサービスにもそれぞれ独自のクローラー名があります。名前や対応状況は変わることがあるため、指定する前に各社の公式ドキュメントで確認してください。
クローラーごとにまとまりを分けて書く
複数のクローラーに別々の指示を出したい場合は、User-agentの行から次のUser-agentの行の前までを1つのまとまりとして書きます。まとまりの間に空行を入れておくと、人が読むときにも分かりやすくなります。
ここで注意したいのは、Googlebot向けのまとまりを作ると、Googlebotは「*」のまとまりのルールを読まなくなるという点です。「*」に書いた共通のルールを、Googlebot向けのまとまりにも書き写しておく必要があります。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: Googlebot
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
中小企業のサイトでクローラーごとにまとまりを分ける必要がある場面は多くありません。書き分けるときは、意図しない漏れがないかを必ず確認してください。
サイト全体を止めるのは公開前の確認用だけ
「Disallow: /」と書くと、サイト全体の巡回が止まります。制作中のテスト環境では使われることがありますが、公開後にこの1行が残っていると、サイトが検索から消えていく原因になります。
公開前のテスト環境を隠したい場合は、robots.txtよりもパスワードによる保護のほうが確実です。公開の切り替え時には、robots.txtの中身を必ず確認する習慣をつけましょう。
Googleがrobots.txtを読み取るときの仕様
robots.txtは、Googleが決めた仕様に沿って読み取られます。ここでは、Googleのクローリングのドキュメントにある仕様のうち、実務でつまずきやすい点を紹介します。
ファイルの大きさと文字コード
Googleが読み取るrobots.txtの大きさは、500キビバイト(KiB)までです。それを超えた部分は無視されるため、ルールが多くなりすぎた場合は、止めたいファイルを1つのフォルダにまとめるなどして短くします。
ファイルは、UTF-8の文字コードで保存したテキストファイルである必要があります。ほかの文字コードで保存すると、一部のルールが正しく読まれないおそれがあります。
Googleは最大24時間ほど内容を覚えている
Googleは、robots.txtの内容をふつう最大24時間キャッシュ(一時保存)します。そのため、robots.txtを書き換えても、すぐにはGoogleの巡回に反映されないことがあります。
急いで反映させたい場合は、後ほど紹介するSearch Consoleのrobots.txtレポートから再クロールをリクエストできます。
エラーのときの扱い
robots.txtを取得したときの応答によって、Googleの扱いは変わります。404などのエラー(429を除く)が返った場合、Googleは「robots.txtがない=巡回の制限なし」と判断します。
一方、サーバーのエラー(5xx)で取得できない場合、Googleは最初の12時間はサイトの巡回を止め、その後30日間は最後に取得できた内容を使います。robots.txtがサーバーエラーを返し続けると、サイト全体の巡回に影響が出ます。
Googleは、サイトを一時停止する場合のドキュメントでも、robots.txtに503を返さないよう案内しています。サーバーの引っ越しやメンテナンスの際は、robots.txtだけは正常に表示されるかを確認しておきましょう。
パスの大文字と小文字は区別される
項目名の大文字と小文字は区別されませんが、DisallowやAllowに書くパス(URLのドメイン以降の部分)は区別されます。たとえば「Disallow: /Private/」と書いても、「/private/」のURLは止まりません。
WordPressのURLは小文字が基本ですが、手作業で作ったフォルダや古い資料のファイル名には大文字が混ざっていることがあります。止めたいURLを実際にブラウザで開き、表記をそのままコピーして書くと間違いを防げます。
リダイレクトの扱い
robots.txtのURLがリダイレクトしている場合、Googleは少なくとも5回まではリダイレクトをたどります。それでもたどり着けなければ、robots.txtがないものとして扱います。
httpからhttpsへの切り替えやドメインの変更をしたときは、新しいURLでrobots.txtが正しく表示されるかを確かめておくと安心です。
robots.txtの設置と確認の手順
続いて、robots.txtを作って設置し、正しく読まれているかを確かめる手順を説明します。WordPressのサイトを例に進めます。
まずは今の中身を確認する
最初に、ブラウザで「自社のドメイン/robots.txt」を開いて、今の内容を確認します。何も表示されない場合や、見覚えのない記述がある場合は、制作会社やサーバーの担当者に確認しましょう。
WordPressの場合、表示されているのが、WordPressが自動で作った内容なのか、実際に置かれたファイルなのかを区別しておくことも大切です。
ファイルを作ってアップロードする
独自の内容にしたい場合は、メモ帳などのテキストエディタで「robots.txt」というファイルを作り、UTF-8で保存します。そのファイルを、FTPソフトやレンタルサーバーのファイル管理画面から、サイトのいちばん上の階層にアップロードします。
実際のファイルを置くと、WordPressが自動で作る内容より優先されます。SEOプラグインのrobots.txt編集機能を使う方法もありますが、どちらで管理しているかを社内で決めておかないと、後で混乱する原因になります。
Search Consoleのrobots.txtレポートで確認する
Search Consoleでは、「設定」の中にある「robots.txt」のレポートで、Googleが取得したrobots.txtの内容や、最後に取得した日時、読み込みで問題が起きていないかを確認できます。このレポートは、ドメインプロパティか、パスを含まないURLプレフィックスプロパティ(例:https://example.com/)で利用できます。
以前あった「robots.txtテスター」は2023年に提供が終わり、このレポートに置き換わりました。古い解説記事でテスターの使い方を見かけても、今は使えない点に注意してください。
書き換える前にバックアップと記録を残す
robots.txtを書き換えるときは、元の内容をテキストファイルなどに保存してから作業します。問題が起きたときに、すぐ元に戻せるようにするためです。
あわせて、書き換えた日付・内容・理由を社内の共有メモに1行残しておきましょう。数年後に「なぜこのフォルダが止められているのか」が分からなくなる、というのはよくある話です。
制作会社に作業を頼んだ場合も、変更の内容を書面やメールで共有してもらうと安心です。
URL検査で個別のページを確かめる
特定のページがrobots.txtで止められていないかは、Search ConsoleのURL検査で確認できます。止められている場合は、ページがクロールできない理由として表示されます。
大切なページがブロックされていた場合は、robots.txtを直したうえで、URL検査から「インデックス登録をリクエスト」を送っておくと安心です。
robots.txtでよくある失敗と注意点
最後に、筆者がご相談を受ける中で特に多い失敗を紹介します。どれも、知っていれば防げるものばかりです。
robots.txtで止めたページにnoindexを入れる
もっとも多いのが、検索から外したいページをrobots.txtで止め、さらにnoindexも入れるケースです。Googleのドキュメントは、robots.txtでクロールを禁止したURLでは、noindexなどの指示が見つけられず無視されると明記しています。
結果として、noindexが効かず、URLだけが検索結果に残り続けることがあります。noindexを効かせたいページは、robots.txtで止めないことが鉄則です。
公開後も「Disallow: /」が残っている
制作会社がテスト用に入れた「Disallow: /」が、公開後もそのまま残っているケースも少なくありません。公開から数週間たっても検索に出てこない場合は、まずrobots.txtを疑ってみてください。
WordPressの「表示設定」にある「検索エンジンがサイトをインデックスしないようにする」のチェックも、あわせて確認しておくと安心です。
隠したい場所をrobots.txtに書いてしまう
robots.txtは誰でも見られるファイルです。「Disallow: /secret-files/」のように書くと、見られたくない場所の名前を自分から公開することになります。
本当に隠したい情報は、robots.txtに書くのではなく、パスワードやアクセス制限で守ってください。robots.txtはセキュリティ対策ではない、という点はぜひ覚えておきましょう。
AI対策のつもりでGooglebotを止める
AIによる概要に自社の情報を使われたくないからと、robots.txtでGooglebotを止めてしまうと、通常の検索結果からも情報が失われていきます。AI検索だけを外したいなら、Search Consoleの検索の生成AI設定を使うのが正しい方法です。
どちらを選ぶ場合も、AI機能からの表示や流入は減ります。Search Consoleの生成AIパフォーマンスレポートで現状を確かめてから判断しましょう。
CSSやJavaScriptのフォルダを止めてしまう
以前は、テーマやプラグインのフォルダをまとめて止める書き方が紹介されることがありました。しかし、CSSやJavaScriptのファイルを止めると、Googleがページの見た目や内容を正しく再現できなくなるおそれがあります。
Googleはページを表示した状態で内容を理解するため、表示に必要なファイルは巡回できるようにしておくのが基本です。「/wp-content/」や「/wp-includes/」をまとめて止めている記述があれば、見直しをおすすめします。
URL検査の「公開URLをテスト」で表示されたスクリーンショットが崩れていないかを見ると、影響の有無を確かめられます。
サーバーやCDNの設定で意図せず止めている
robots.txtが正しくても、サーバーのセキュリティ設定やCDN(コンテンツを配信するサービス)の設定で、Googlebotのアクセスを止めてしまっていることがあります。2026年9月15日には、CloudflareがAIクローラーへの初期設定を変更し、設定によってはGooglebotのような複数の目的を持つクローラーまで止まる場合があると報じられました。
設定を変えたときは、Search Consoleのクロールの統計情報やURL検査で、Googlebotが問題なく巡回できているかを確認してください。
よくある質問(FAQ)
robots.txtがなくても問題ありませんか?
robots.txtがなくても、Googleは「巡回の制限なし」と判断してサイトを巡回します。小規模なサイトであれば、robots.txtがないことで大きな問題になることはほとんどありません。
ただし、サイトマップの場所を伝えられるなどの利点があるため、標準的な内容のrobots.txtを置いておくことをおすすめします。WordPressなら自動で用意されます。
robots.txtで止めれば、検索結果から消えますか?
Webページの場合、robots.txtで止めても検索結果から消えるとは限りません。ほかのサイトからリンクされていれば、URLだけが表示されることがあります。
確実に検索結果から外したいときは、robots.txtで止めずにnoindexを使います。robots.txtが向いているのは、画像や動画のファイルを止める場合です。
robots.txtを書き換えたら、いつ反映されますか?
Googleはrobots.txtをふつう最大24時間キャッシュするため、反映まで1日ほどかかることがあります。Search Consoleのrobots.txtレポートから再クロールをリクエストすると、早まる場合があります。
なお、巡回の範囲が変わっても、検索結果の表示が変わるまでにはさらに時間がかかります。反映の時期を確約することはできない点をご理解ください。
AIに自社サイトを使われたくない場合はどうすればよいですか?
Googleの検索結果のAI機能から外したい場合は、Search Consoleの検索の生成AI設定を使います。Geminiモデルの学習や、Geminiアプリなどでの利用を制限したい場合は、robots.txtでGoogle-Extendedを指定します。
他社のAIサービスについては、各社が公開しているクローラー名を確認して、robots.txtで個別に指定します。著作権など法的な判断が必要な場合は、弁護士など専門家にご相談ください。
サブドメインごとにrobots.txtが必要ですか?
はい。robots.txtは、置いたファイルと同じホスト名のURLにしか効きません。
「www.」の有無や「blog.」などのサブドメインごとに、それぞれのいちばん上の階層にrobots.txtを用意します。
wwwあり・なしのどちらかに統一してリダイレクトしている場合は、統一した側のrobots.txtが正しく表示されるかを確認しておけば十分です。
robots.txtでSEOの効果は上がりますか?
robots.txtを書くだけで順位が上がるわけではありません。ただし、不要なページへの巡回を減らし、大切なページを正しく巡回してもらうための土台になります。
特にページ数が多いサイトでは、巡回の効率に影響することがあります。中小企業のサイトでは、まず「大切なページを止めていないか」を確認することが何より重要です。
まとめ|robots.txtは「止めすぎない」ことが大切
robots.txtは、クローラーにサイトのどこを巡回してよいかを伝えるファイルです。検索結果に出さないための仕組みではなく、ページを検索から外したいときはnoindexを使う、という違いが基本になります。
この1年で、Googleは検索に出す内容を制限する方法を公式ページで改めて整理し、robots.txtの対象は画像と動画、Webページにはnoindex、という区別を示しています。また、AI検索だけを外すSearch Consoleの検索の生成AI設定や、Googleのほかの生成AIサービス向けのGoogle-Extendedなど、目的ごとの手段もそろっています。
書き方は、User-agent・Disallow・Allow・Sitemapの4項目だけです。中小企業のサイトの多くは、WordPressの標準的な内容で十分で、むしろ止めすぎによる失敗のほうが目立ちます。
まずは今日、自社のrobots.txtを開いて中身を確認し、「Disallow: /」のようにサイト全体を止める記述がないかを見てみてください。あわせてSearch Consoleのrobots.txtレポートを開けば、Googleが正しく読み取れているかも確かめられます。
SEO対策のご相談はアクセス・リンクへ
株式会社アクセス・リンクでは、全日本SEO協会認定SEOコンサルタントの三田健司が、中小企業のホームページのSEO対策とAI検索対策をお手伝いしています。robots.txtやnoindexの設定確認から、Search Consoleを使った現状の調査まで、サイトの状況に合わせてご提案します。
Web制作とSEOに10年以上携わり、延べ1,000件以上のご相談に対応してきた経験をもとに、専門用語をできるだけ使わずにご説明します。「自社のrobots.txtが正しいか見てほしい」といったご相談だけでもお気軽にどうぞ。
ご相談はお問い合わせフォームから受け付けています。
記事執筆・株式会社アクセス・リンク 代表取締役
Webサイト制作歴10年以上の経験を元にSEOコンサルティングを行い、延べ1,000件以上のサポート実績を誇ります。個人事業主や中小企業向けのホームページ制作やSEOコンサルティングを得意としています。
(社)全日本SEO協会 認定SEOコンサルタント
コメント